

디지털 인프라의 패러다임이 빅데이터를 넘어 인공지능(AI) 시대로 완벽하게 전환되었습니다. 초거대 생성형 AI 모델의 학습과 추론, 그리고 하이브리드 클라우드 인프라가 고도화되면서 데이터센터 내부의 트래픽을 지능적이고 신속하게 처리하는 고성능 스토리지의 가치는 그 어느 때보다 커졌습니다. 과거에는 연산 성능(Compute)이 시스템의 생존을 결정했다면, 이제는 스토리지의 I/O 처리 속도가 전체 인프라의 생산성을 결정짓는 핵심 컴포넌트가 되었습니다.
IT 인프라 컨설턴트로서 저는 과거 HPC 슈퍼컴퓨팅의 황금기부터 비정형 빅데이터 시대를 지나, 지금의 AI 인프라 변혁기까지 수많은 스토리지 비즈니스를 현장에서 전개해 왔습니다. 이 거대한 여정 속에서 언제나 흔들리지 않는 표준이자 신뢰의 상징이었던 스토리지가 바로 IBM SSS (Storage Scale System, 과거 Elastic Storage Server/ESS)입니다.
이번 칼럼에서는 IBM SSS가 가진 역사적 헤리티지와 독보적인 아키텍처, 그리고 초고가 GPU의 유휴 타임을 최소화하여 투자대비효율(ROI)을 극대화하는 세일즈 전략을 심층 분석해 봅니다.
1. HPC 명가의 DNA: ESS에서 SSS까지 이어진 역사적 계보
IBM SSS의 뿌리를 이해하기 위해서는 글로벌 슈퍼컴퓨팅(HPC) 역사와 함께한 계보를 짚어볼 필요가 있습니다.
- 슈퍼컴퓨팅의 절대 기준, ESS: 과거 초고속 인피니밴드(Infiniband) 네트워크로 연결되어 데이터 분산 처리를 호령했던 IBM ESS(Elastic Storage Server)는 초고속 병렬 파일 시스템의 글로벌 표준이었습니다. 전 세계 탑티어 연구소와 기상청 등 대규모 연산이 필수적인 환경에서 ‘가장 신뢰할 수 있는 병렬 스토리지’로 자리 잡았습니다.
- 비정형 빅데이터라는 거대한 그릇: 이후 시대는 단순 연산을 넘어 ‘비정형 대용량 데이터’를 어떻게 담아내고 분석할 것인가의 싸움으로 전환되었습니다. 저 역시 현장에서 ESS를 기반으로 수 페타바이트(PB) 규모의 빅데이터 저장소를 구축하며, 데이터 사일로(Silo)를 제거하고 무중단 확장을 구현하는 비즈니스를 전개한 깊은 경험이 있습니다.
- AI 특화 플랫폼, SSS로의 진화: 이 강력한 소프트웨어 정의 스토리지(SDS) 아키텍처는 최근 NVMe 플래시 하드웨어 기술과 완벽하게 결합되면서 IBM SSS(Storage Scale System)라는 독자적인 고성능 전문 브랜드로 온전히 안착했습니다.
이 헤리티지는 단순한 과거의 유산이 아닙니다. 왜 IBM SSS가 하이엔드 AI 데이터 인프라 시장에서 그토록 압도적인 하드웨어 안정성과 독보적인 성능을 발휘하는지 증명하는 가장 확실한 기술적 팩트(Fact)입니다.
2. 일반 SAN/NAS가 범접할 수 없는 IBM SSS의 핵심 기술 아키텍처
시중의 일반적인 SAN(Storage Area Network)이나 NAS(Network Attached Network) 스토리지는 컨트롤러 노드가 병목 지점이 되는 구조적 한계를 가집니다. 반면 IBM SSS는根本적으로 다른 아키텍처를 자랑합니다.
1) 진정한 병렬 파일 시스템: IBM Storage Scale (구 GPFS)
IBM SSS의 코어에는 전설적인 병렬 파일 시스템인 GPFS(General Parallel File System)의 최신 진화형인 ‘Storage Scale’ 소프트웨어가 탑재되어 있습니다. 단일 컨트롤러가 트래픽을 처리하는 NAS와 달리, 수천 개의 연산 노드가 스토리지 드라이브에 동시에 직접(Parallel) 접근하여 데이터를 읽고 씁니다. 드라이브가 늘어나는 만큼 성능과 대역폭이 선형적으로 확장되는 진정한 스케일아웃(Scale-Out) 구조입니다.
2) 디클러스터드 RAID (Declustered RAID)를 통한 신뢰성 혁신
전통적인 하드웨어 RAID는 대용량 드라이브 장애 시 복구(Rebuild)에 며칠이 소요되며 성능 저하를 유발합니다. 하지만 IBM SSS의 이레이저 코딩(Erasure Coding) 기반 디클러스터드 RAID는 디스크 장애 발생 시 클러스터 내의 수많은 잔여 디스크가 동시에 복구 작업에 참여합니다. 이로 인해 성능 저하를 최소화하면서 단 몇 분 만에 완벽한 데이터 복구를 완료하여 시스템 연속성을 보장합니다.
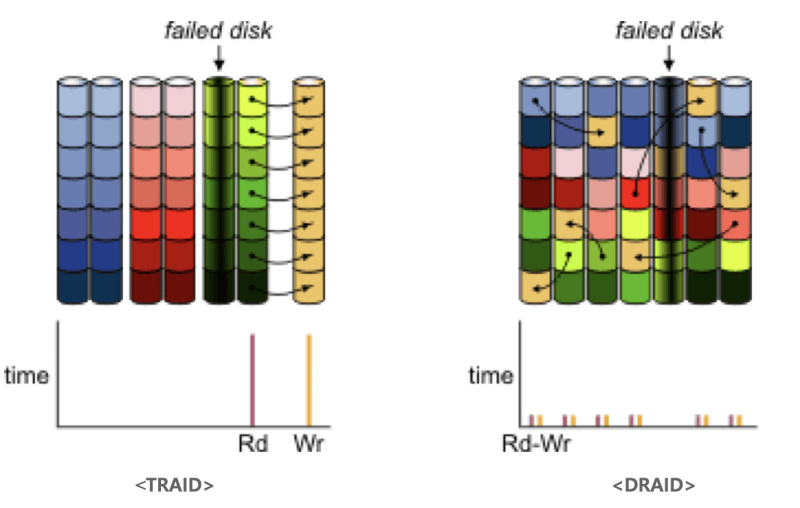
3. 초고속 네트워킹 최신 기술과 광범위한 프로토콜 호환성
IBM SSS는 인공지능 인프라의 핵심인 초고속 네트워크 대역폭을 손실 없이 수용할 수 있는 인터페이스와 프로토콜 포트폴리오를 제공합니다.
- 인피니밴드(Infiniband) 및 NVMe-oF 결합: 최신 제품군(예: IBM SSS 6000, ESS 3200)은 PCIe v4/v5 인프라와 HDR/NDR 인피니밴드 및 100G/200G 이더넷을 최대 8포트 이상 수용합니다. 특히 NVMe-oF(NVMe over Fabrics) 기술을 통해 원격지 스토리지 하드웨어를 마치 로컬 가상머신 내부의 NVMe SSD처럼 초저지연(Low-Latency)으로 제어합니다.
- 멀티 프로토콜의 유연성: 고성능 분산 처리를 위한 표준인 POSIX와 글로벌 병렬 파일 프로토콜인 GPFS를 코어로 삼으면서도 엔터프라이즈 환경에서 필수적인 NFS v4.0, SMB v3.0을 기본 지원합니다. 이에 더해 빅데이터 분석용 Hadoop MapReduce, 하이브리드 클라우드와 컨테이너 환경을 가속하는 S3(오브젝트 스토리지) 및 CSI(Container Storage Interface) 드라이버까지 하나의 스토리지 안에서 완벽하게 상호 호환됩니다.
4. AI 인프라의 핵심 전략: 고가 GPU의 ‘유휴 타임’을 제로(0)화하라
최근 AI 비즈니스를 전개하는 엔터프라이즈와 공공기관의 가장 큰 고민은 “인프라 예산의 대부분을 차지하는 엔비디아(NVIDIA) 등 고가의 GPU 자원이 제 성능을 다 내고 있는가?”입니다.
많은 경우, GPU의 연산 속도를 스토리지가 따라가지 못해 GPU가 데이터를 기다리며 노는 ‘GPU 유휴 상태(GPU Starvation)’ 현상이 발생합니다. 이는 엄청난 예산 낭비이자 AI 모델 자산의 생산성을 떨어뜨리는 주범입니다.
NVIDIA GPUDirect Storage(GDS) 완벽 지원
IBM SSS의 진가는 여기서 발휘됩니다. IBM SSS는 엔비디아의 GPUDirect Storage(GDS) 기술을 기본 아키텍처 레벨에서 완벽하게 수용합니다.
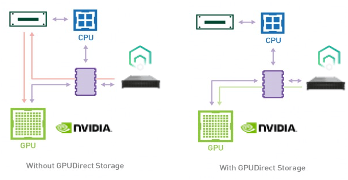
GDS 기술이 적용된 IBM SSS는 데이터가 호스트 CPU 버스와 시스템 메모리를 거치는 데이터 오프로딩 단계를 완전히 생략합니다. 스토리지에서 GPU 메모리로 직접(Direct) 데이터를 초고속 패스로 쏴주기 때문에, 최대 340GB/s 이상의 무지막지한 처리량(Throughput)과 초저지연을 달성합니다.
결과적으로 고가의 GPU 서버가 단 1초도 쉬지 않고 풀타임으로 AI 딥러닝 학습과 대규모 추론 연산에만 몰두할 수 있는 최적의 환경을 보장합니다.
[가상 사례] AI 기반 미래 기후 예측 연구소의 TCO 혁신 스토리
수십 대의 하이엔드 GPU 서버를 도입하여 인공지능 기반 미세먼지 및 기후 예측 모델을 개발하던 한 연구소는 지속적인 성능 저하에 시달렸습니다. 최고 사양의 GPU를 풀가동했음에도 AI 모델의 대규모 데이터셋 학습 연산 속도가 기대치에 한참 못 미쳤던 것입니다. 원인을 분석해 보니 데이터센터에 구축된 일반 NAS 스토리지가 수십 만 개의 기상 이미지 및 정형·비정형 텍스트 데이터를 GPU로 밀어 넣어주지 못해 발생하는 ‘I/O 병목’이 원인이었습니다.
이 연구소는 해결책으로 NVIDIA GDS를 지원하는 IBM SSS All-Flash 라인업을 전격 도입했습니다. 데이터가 CPU를 거치지 않고 스토리지에서 GPU 메모리로 다이렉트로 전송되자 시스템 대역폭이 획기적으로 개선되었습니다. 그 결과, 기존에 평균 2주일이 소요되던 예측 모델의 전체 학습 주기가 단 3일로 단축되었습니다. 스토리지 하나를 교체했을 뿐인데, 유휴 타임이 사라진 GPU의 생산성이 4배 이상 급증하며 수십억 원 상당의 GPU 추가 도입 예산을 절감하는 강력한 TCO 혁신을 증명해 냈습니다.
5. 코어(Core) 시스템부터 하이브리드 클라우드까지 아우르는 최고의 투자대비효율(ROI)
IBM SSS는 단순히 AI만을 위한 일회성 장비가 아닙니다. 엔터프라이즈의 가장 깊숙한 코어(Core) 시스템부터 고성능 연산이 필요한 모든 환경에서 투자 효율성을 보장합니다.
- 성능과 데이터 관리의 유연성 극대화: 무제한에 가까운 확장성(엑사바이트/EB 규모 지원)을 자랑하면서도 단일 네 네임스페이스 공간 내에서 모든 데이터를 다룹니다. 이에 따라 복잡한 기업 내 데이터 자산의 관리가 극도로 단순해집니다.
- 글로벌 데이터 플랫폼 및 계층화 정책: 자주 쓰이는 핫 데이터(Hot Data)는 초고속 NVMe 플래시 영역(SSS 6000 등)에 배치하고, 오랜 기간 보관해야 하는 콜드 데이터(Cold Data)는 정책 기반의 티어링(Tiering) 기술을 통해 비용 효율적인 고용량 디스크나 클라우드 오브젝트 영역으로 자동으로 이동시킵니다.
인프라 예산의 유연성과 합리적 소비가 중요한 현재 시장 상황에서, IBM SSS는 단 한 번의 아키텍처 투자로 AI, 빅데이터 분석, 레가시 코어 시스템의 고성능 트래픽을 모두 수용하는 영리한 인프라 통합(Consolidation) 대안이 됩니다.
🔚 에필로그: 데이터 병목의 시대를 돌파할 마스터키
빅데이터 시대의 데이터 그릇 역할을 넘어 이제 GPU 컴퓨팅의 엔진으로 진화한 IBM SSS는 인프라 담당자들이 신뢰할 수 있는 가장 확실한 데이터 플랫폼입니다. 과거 슈퍼컴퓨팅 시장에서 검증된 강력한 병렬 아키텍처의 헤리티지가 최신의 NVMe 및 인피니밴드 기술과 만나 AI 시대의 데이터 갈증을 해결해 주고 있습니다.
데이터센터 내부의 수많은 트래픽과 GPU의 성능 병목을 깨고 비즈니스의 가치를 실시간으로 창출하고 싶다면, 신뢰의 계보를 이어온 IBM SSS 아키텍처를 dcsquare.net과 함께 검토해 보시기 바랍니다.
- IBM SSS 고성능 데이터 플랫폼 아키텍처 컨설팅 및 도입 문의: di@iworks.kr


[…] […]